Agile
Development
UX/UI
Digitalisierung
Clean Code
15.8.25
Dual Track Agile: Moderne Softwareentwicklung
Hier erfährst Du, was Dual-Track Agile ist und wie es bei der der Software- und Produktentwicklung helfen kann!
Softwareentwicklung mit KI ist schneller geworden. Qualität und Kontrolle folgen daraus nicht von selbst. Bevor KI oder Mensch auch nur eine Zeile Code schreiben, muss geklärt sein, welches Problem mit welchen Anforderungen und in welchem Kontext gelöst werden soll. Danach geht es darum, so zu entwickeln, dass die Software prüfbar, wartbar und über Jahre weiterentwickelbar bleibt. In diesem Artikel geht es um KI in der Softwareentwicklung: Was leistet ein Sprachmodell wirklich, und welche Erwartungen an Tempo, Daten und fertige Produkte halten in komplexen Industrieprozessen nicht stand?
Ziel dieses Artikels: Nach dem Lesen können Sie kritische Muster im Unternehmensalltag erkennen: im Review, im Jour fixe, in der Demo und in der Fertigung. Sie wissen, woran KI scheitert, wenn Kontext, Requirements und Qualität fehlen. Und Sie haben einen Maßstab dafür, was es in der Praxis heißt, zuerst das Problem und die Anforderungen zu klären und dann so zu entwickeln, dass die Software verantwortbar bleibt.
Das Richtige richtig zu entwickeln, scheitert selten am Tool, sondern an fünf Mustern, die sich ständig wiederholen. Kommen Ihnen diese Punkte bekannt vor?
Fehlender KI-Tool-Standard: Ob Copilot, ChatGPT oder Cursor, die einen lehnen es ab, die anderen haben klare Vorlieben. Wegzudenken ist KI aus der Softwareentwicklung nicht mehr, aber oft ist das, was bei der Nutzung hinten rauskommt, fragwürdig. Das häufigste Problem: Es gibt keinen gemeinsamen Standard, wie im Unternehmen Software mit KI entwickelt wird.
Vibe-Coding-App in zwei Tagen: Mit Vibe-Coding ist schnell eine Oberfläche entwickelt, die sich fertig anfühlt und gut aussieht. Was beim Vibe-Coding allerdings oft vernachlässigt wird, sind Architektur, Strategie und langfristige Planung. Wie fügt sich die Software in bestehende Prozesse und Systeme ein? Wo liegt die Ownership?
Das falsche Feature, nur schneller: Zwischen Fachbereich und Entwicklern geht unterwegs häufig etwas verloren. Der Austausch findet zu selten statt und so wird eher auf Basis von Annahmen als von Anforderungen entwickelt. Bemerkt wird das oft erst, wenn es fertig ist. Mit KI wird das schärfer: Ein dritter Akteur spielt mit und füllt Lücken mit dem Wahrscheinlichsten. Gutes Requirements Engineering wird dadurch noch wichtiger, damit KI-Modelle nicht Tokens verheizen, um das falsche Problem zu lösen.
Kontrollverlust: Der Code wurde vom Dienstleister neu entwickelt, die Tests sind grün und trotzdem können Sie Qualität, Nachvollziehbarkeit und Wartbarkeit ohne Clean-Code-Standards nicht mehr prüfen. Und plötzlich müssen Sie Zeit und Geld investieren, um sich Wissen anzueignen und Abhängigkeiten zu vermeiden, statt Ihrem Kerngeschäft nachzugehen.
„Können wir das nicht selbst mit KI?“ In der Theorie lautet die Antwort Ja, in der Praxis ist die Frage, ob ausreichend Expertise vorhanden ist, damit aus einzelnen Versuchen auch Entscheidungen für konkrete Probleme werden. KI ist kein schneller Problemlöser, ohne Menschen, die den Einsatz verstehen, richtig prompten, den nötigen Kontext liefern und die Qualität prüfen.
Die meisten Menschen, mit denen wir sprechen, erkennen sich in mindestens einem dieser fünf Punkte wieder oder haben uns selbst von diesen Problemen berichtet.
Ein LLM füllt jede Lücke, die Sie offen lassen, mit dem Wahrscheinlichsten, nicht mit dem für Sie Richtigen. Die Lücke wird nicht als Lücke sichtbar. Sie wird mit einer flüssigen, überzeugenden Vermutung geschlossen.
Beginnen wir mit dem, was ein Sprachmodell tatsächlich tut: Ein KI-Modell ist ein Wahrscheinlichkeitsmodell, das laufend Annahmen trifft, ohne zwingend belegbare Beweise dafür zu haben.
Ein Large Language Model (LLM) versteht nicht. Es sucht.
Token für Token ermittelt es die wahrscheinlichste Fortsetzung. Grundlage dafür ist der Kontext, den Sie ihm geben, plus das Vorwissen aus dem Training. Fehlt Kontext, kann es den Treffer nicht sauber ermitteln und greift auf Annahmen zurück. Genau daraus entstehen die Probleme, um die es in diesem Blogpost geht.
„Thinking“-Modi ändern daran nichts Grundsätzliches: Sie geben der Suche mehr Rechenzeit, erzeugen jedoch keine Einsicht. Ohne klaren Plan, Ziel und Struktur verbraucht das Modell (teure) Token damit, sich erst hin zu iterieren, statt von Anfang an die richtige Lösung zu treffen.
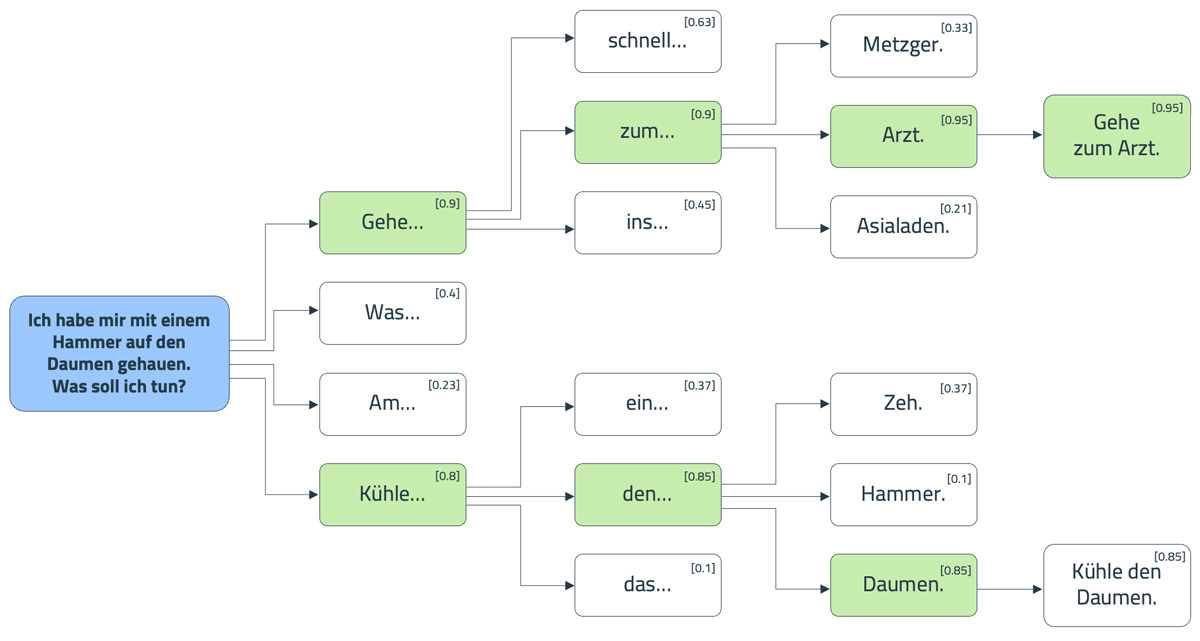
Genau das macht KI in der Softwareentwicklung mächtig und riskant zugleich. Mächtig, weil das manuelle Schreiben jetzt einen noch geringeren Teil ausmacht. Riskant, weil das Modell keine Unschärfe anzeigt. Es liefert in hoher Geschwindigkeit Code, der sich liest, als hätte jemand nachgedacht.
Deshalb gilt: Guter Input erhöht die Wahrscheinlichkeit, einen richtigen Treffer zu landen, der zu Ihren Anforderungen, Ihrer Architektur und Ihren Zielen passt.
Das ist im Sinne der Ressourcen im Team nachhaltiger, weil weniger nachgeschliffen werden muss. Und kosteneffizient, weil weniger Token in falsche Iterationen fließen. Requirements, Architektur, Domänenregeln, bestehende Codebasis, testbare Akzeptanzkriterien: Was nicht im Kontext steht und nicht im Training steckt, wird geraten.
Kent Beck, Mitbegründer von Extreme Programming, bringt die Verschiebung auf den Punkt:
„90 % of my skills are now worth $0 … but the other 10 % are worth 1000x.“ (Kent Beck)
Die 10 Prozent sind intelligentes Urteil, starke Architektur und sinnvoller Kontext.
Was das konkret für ein Industrieunternehmen heißt: KI in der Softwareentwicklung bedeutet nicht „wir haben jetzt ein Chatfenster in der IDE“. Sie bedeutet, dass die eigentliche Arbeit sichtbar wird, die vorher im Schreiben versteckt war: das Richtige identifizieren und absichern, dass es richtig entwickelt wird.
In Gesprächen mit CTOs, Entwicklungsleitungen und Fachbereichen tauchen immer wieder dieselben Annahmen darüber auf, was KI in der Softwareentwicklung kann. Dabei wird die KI häufig überschätzt.
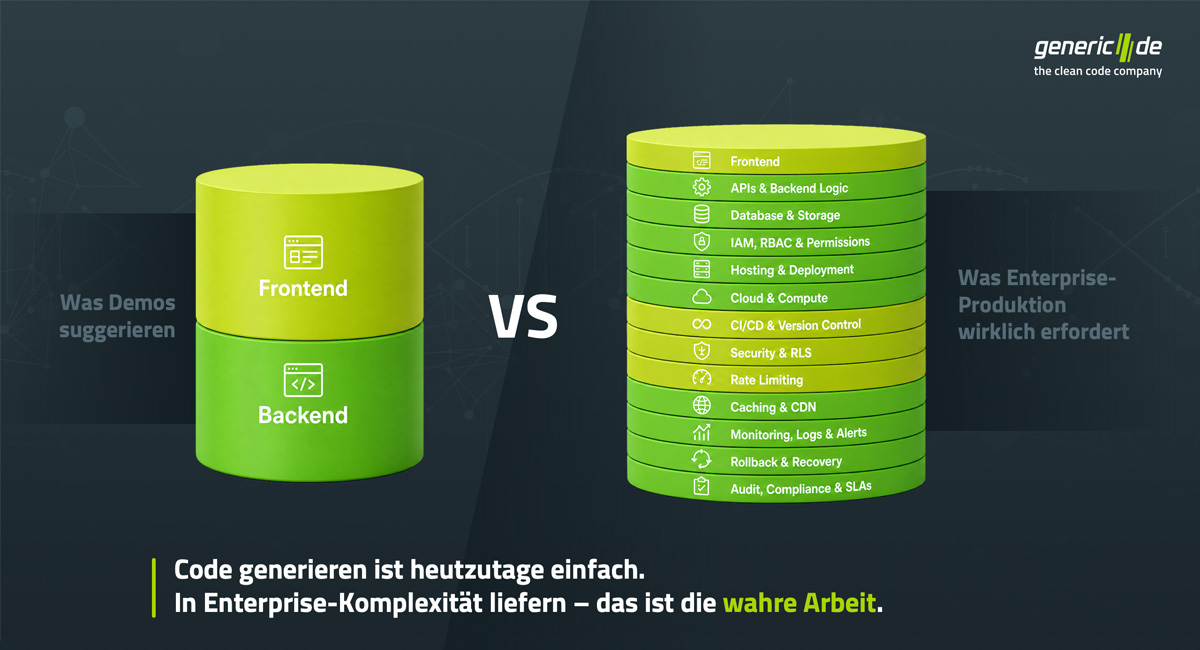
Ein Vibe-Coding-Prototyp ist kein Produkt.
In der produzierenden Industrie muss Software in reale Prozesse, Systeme und den Betrieb passen. Bei einem komplexen Ablauf kann KI unterstützen. Sie löst aber nicht „einfach mal“ die Herausforderungen, die damit einhergehen.
Der Engpass ist oft das Verständnis der Geschäftsprozesse: Daten und Systeme müssen zusammenfinden, häufig über Standorte und Länder hinweg. Wo die Verbindung fehlt, springt ein Mensch ein. Ist dieser Ablauf ohne KI schon brüchig, macht „KI obendrauf“ bei komplexen Unternehmensprozessen selten den entscheidenden Unterschied.
Eine KI räumt die Datenbasis nicht von selbst auf. Sie kann beim Strukturieren helfen. Verantwortung für das Datenfundament und die Kontrolle der Qualität bleiben beim Menschen.
Entwicklerinnen und Entwickler werden nicht überflüssig. Der State of DevOps Report 2025 (eine jährliche Studie zur Lieferfähigkeit von Softwareteams) zeigt: Einzelne erledigen mehr Tasks und mergen mehr Pull Requests. Die gesparte Zeit wandert oft in Prüfung und Freigabe.
Ein Entwickler formulierte es so:
„Ich babysitte die KI und prüfe, was sie tut.“
Die Arbeit wird nicht weniger, sie verschiebt sich nur.
Viele Unternehmen haben eine Liste offener Themen und prüfen, was sich mit KI lösen lässt. Das Modell arbeitet diese Liste nicht von allein ab. Es braucht Menschen, die den Einsatz einordnen, Ergebnisse prüfen und den Kontext liefern. Sonst bleibt die Suche statistisch, nicht treffsicher.
Und noch eine Abgrenzung, weil sie in der Praxis teuer wird: KI in der Softwareentwicklung ist nicht dasselbe wie KI im Produkt. Das eine ist, wie ein Team entwickelt. Das andere ist, was das Produkt kann: Bildverarbeitung, Prognose, Assistenz. Beides kann zusammengehören. Vermischen sollte man die Entscheidung nicht.
Das ist der Satz, unter den wir bei generic.de seit Jahren unsere Arbeit stellen. Mit KI in der Softwareentwicklung wird er umso wichtiger, weil ein falsches Ergebnis jetzt noch viel schneller entwickelt ist.
Der Satz inkludiert die zwei wichtigsten Rahmenbedingungen in der Softwareentwicklung.
Das Richtige heißt: ein Problem zu lösen, das es wert ist, gelöst zu werden.
Richtig heißt: Software entwickeln, die wartbar, prüfbar und über Jahre hinweg weiterentwickelbar ist.
Um diese Philosophie einzulösen, entwickeln wir Software mit KI in Phasen, greifen auf einen umfassenden Knowledge Graph zurück und lassen mit Dual Track Agile Discovery und das eigentliche Coden parallel laufen. Um die Qualität auch bei hohem Tempo zu sichern, arbeiten wir dabei mit Loops und Quality Gates.
Ein Entwicklungsteam hat noch nie hauptsächlich Code entwickelt. Es klärt Anforderungen, entscheidet Architektur, plant, entwickelt, testet, reviewed und bringt Software in Betrieb. Genau dort liegt insbesondere, seit KI in der Softwareentwicklung eine übergeordnete Rolle spielt, der echte Mehrwert in der Wertschöpfungskette.
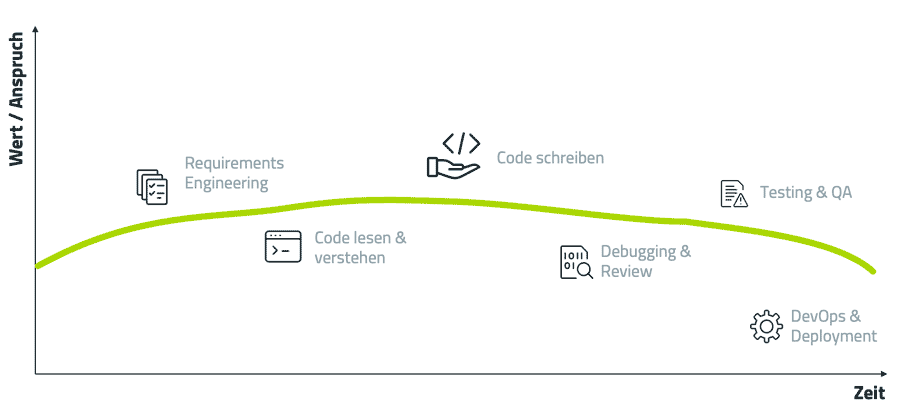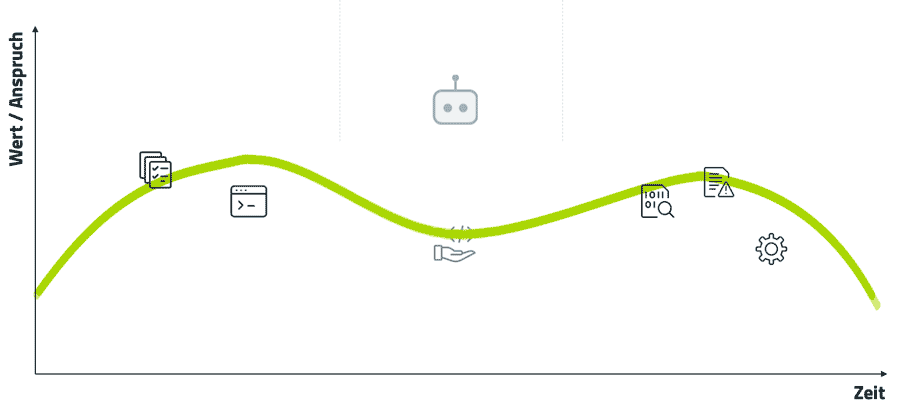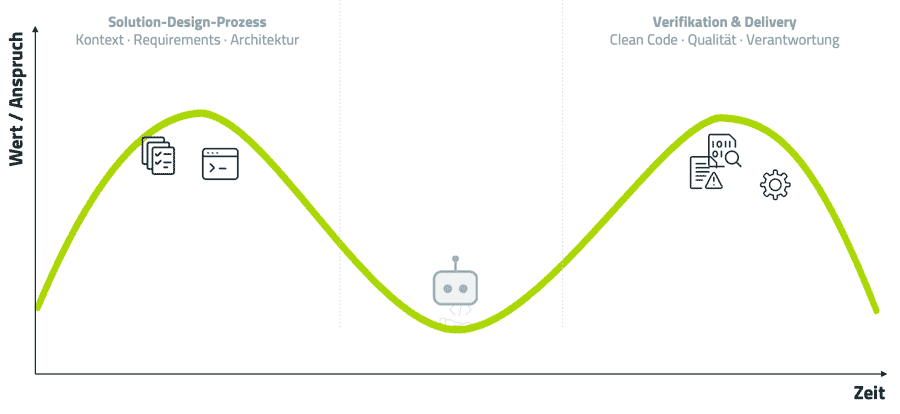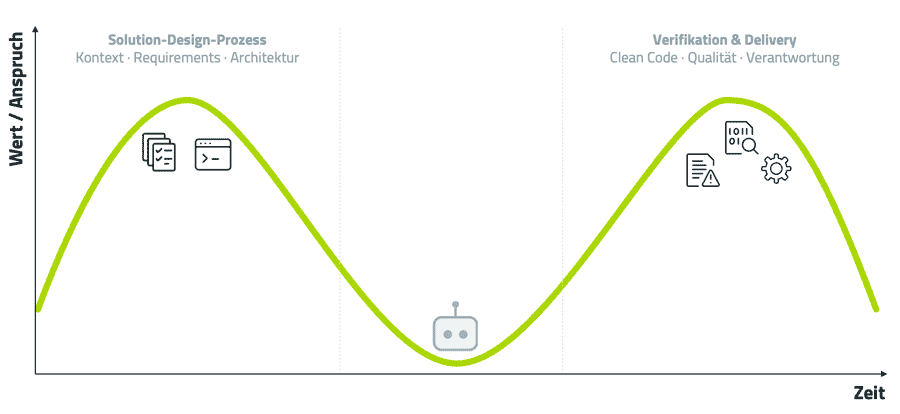
Damit wird deutlich, dass Requirements Engineering und Review heute noch wichtiger werden. Bevor KI oder Mensch auch nur eine Zeile Code schreiben, muss geklärt werden, was entstehen soll und in welchem Kontext. Es geht darum, das Richtige zu entwickeln. Review bedeutet, sicherzustellen, dass der Code, den Agenten geschrieben haben, auch von Menschen verantwortet werden kann. Wurde das Richtige auch richtig umgesetzt.
Wer Requirements Engineering und Review vernachlässigt, zahlt meist dreifach: in Lösungen, die keiner braucht, in technischen Schulden und in Software, die niemand mehr versteht.
Der letzte Punkt hat seit 2026 einen Namen: Comprehension Debt (Addy Osmani).
Klassische technische Schuld heißt: Der Code ist schlecht. Comprehension Debt heißt: Der Code ist vielleicht sogar sauber, aber niemand versteht ihn.
Um das Richtige richtig zu entwickeln, denken wir den Prozess der Softwareentwicklung in vier Phasen: Erfinden, Erforschen, Entwickeln und Erhalten.
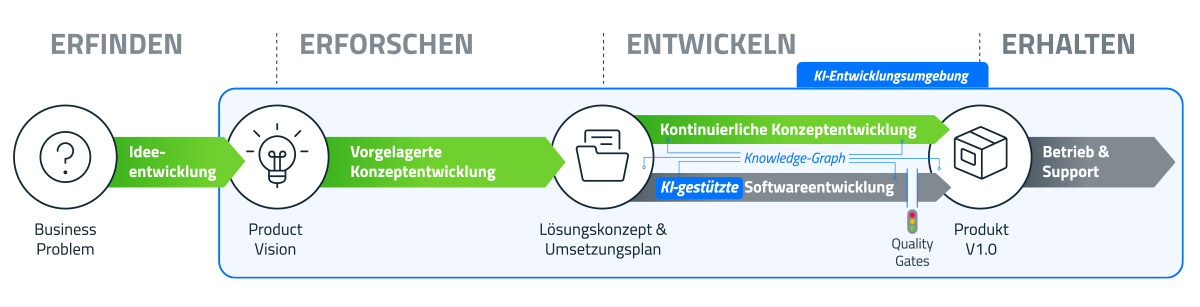
In der ersten Projektphase werden Business-Probleme identifiziert und priorisiert, um Lösungsideen zu generieren und eine Vision zu formulieren.
Der Fokus liegt darauf, in die Lösung des richtigen Problems zu investieren, Entscheidungssicherheit zu schaffen und Orientierung für das Team und die Stakeholder zu schaffen.
In diesem Schritt findet auch die Bestandsaufnahme (Requirements Engineering) statt. Die wichtigsten Anforderungen und Spezifikationen werden gebündelt und zusammengefasst.
Das Lösungskonzept wird in der zweiten Projektphase in einen Knowledge Graph übersetzt. In dieser maschinenlesbaren Wissensdatenbank sind Dokumente so strukturiert und verknüpft, dass die KI Abhängigkeiten versteht und in der Softwareentwicklung berücksichtigen kann.
In den Knowledge-Graph gehören Anforderungen, Entscheidungen, Produktversionen, Kundenaussagen, Angebotsinhalte und die relevanten Dateien, in möglichst hoher Qualität. Der Graph wird über alle Phasen hinweg erweitert, ähnlich wie ein Wiki: Änderungswünsche, neue Kundenanforderungen, neue Beteiligte, Technologieentscheidungen, dazu die Historie der Entscheidungen und ihrer Begründungen.
Parallel dazu wird das Projekt inklusive der KI-Entwicklungsumgebung aufgesetzt. Hierzu richten wir einen individuellen Agent-Harness ein.
Ein Agent Harness ist die Umgebung um das Sprachmodell herum. Das LLM liefert nur einen kleinen Teil der Wertschöpfung (Richtwert ~10 %); der Harness macht den Rest (~90 %), indem er das Modell nutzbar, steuerbar, sicher und wiederholbar macht. Er umfasst Schichten von innen nach außen: Framework (Instructions, Tools, Orchestrierung, Guardrails), Developer-Interface, Cloud-Infrastruktur sowie Querschnitte wie Memory, Tests, Observability und Deployment. Kern ist der definierte Informationsfluss: festgelegte Eingaben werden zu festgelegte Ausgaben verarbeitet.
Erst wenn dieses Fundament steht, ist ein Vorhaben dev-ready. Weder Mensch noch Agent schreibt Code, bevor klar ist, was entstehen soll und unter welchen Voraussetzungen.
Hier findet die eigentliche Softwareentwicklung statt. Im Dual-Track-Agile-Verfahren laufen Discovery und Delivery parallel. KI-Agenten beschleunigen Routinen, Code und Tests, während unsere Expert:innen konzipieren, planen und prüfen. Neue Produktinkremente können früher vertestet werden, um das Konzept kontinuierlich mit Nutzerfeedback anzureichern. So sinkt das Produktrisiko, der erzeugte Code bleibt Eigentum des Auftraggebers und ist dank Quality Gates durch Mensch und KI wart- und weiterentwickelbar.
Mit dem Go-live endet die Verantwortung nicht: Betrieb, Hosting, Support, Security-Updates und Weiterentwicklung sorgen dafür, dass aus sauber entwickeltem Code kein Produkt mit Comprehension Debt wird, sondern eines, das auch in fünf oder zehn Jahren noch verantwortbar bleibt.
Requirements Engineering und die Entwicklung eines Knowledge Graphen gehören seit jeher zur Softwareentwicklung. Neu ist, dass mit KI in der Softwareentwicklung ein weiterer Akteur denselben Kontext braucht wie früher nur der menschliche Entwickler: das Modell.
Context Engineering sorgt in der Praxis dafür, dass die Requirements und andere Daten aus dem Knowledge Graph für die KI überhaupt lesbar und verfügbar werden.
Dabei geht es um Auswahl, nicht um Vollständigkeit. Den kompletten Graph in jeden Prompt zu laden, wäre keine Lösung, sondern ein neues Problem. Ab einem gewissen Kontextvolumen nimmt die Outputqualität der KI rapide ab.
Context Engineering bedeutet deshalb, für jede Task gezielt den relevanten Ausschnitt aus dem Graph zu bestimmen und bereitzustellen, statt möglichst viel Kontext auf einmal zu liefern.
Eine Analogie macht greifbar, was passiert, wenn dieser Schritt fehlt. Ein Architekt weiß implizit, dass Fenster und Türen ins Haus gehören und dass Menschen hindurchgehen müssen. Dieses Wissen steht in keinem Plan, es sitzt im Kopf. Fehlt der KI genau dieser Verwendungskontext, setzt sie die Tür einen Meter zu hoch oder baut eine Vogelhäuschentür in ein Menschenhaus, statistisch plausibel, aber praktisch unbrauchbar.
Das Thema Agent Harness wurde in den vier Phasen von KI in der Softwareentwicklung schon aufgegriffen. Hier tauchen wir nochmal ein bisschen tiefer ein. Früher hatten Entwickler:innen solche Prüfschleifen im Kopf. Heute muss das, was in den Köpfen steckte, der KI zur Verfügung gestellt werden.
Quality Gates, Loops und Guardrails sorgen im Rahmen des Agent Harness dafür, dass die KI die festgelegte Route nicht verlässt.
Guardrails sind in gewisser Weise die Verkehrsregeln, an die sich das KI-Modell halten muss. Quality Gates sind die Grenzposten, an denen das Zwischenergebnis kontrolliert wird.
Gemeinsam verhindern sie, dass das statistische Mittelmaß und die Wahrscheinlichkeitsannahmen der KI unbemerkt implementiert werden.
Loops sind die Fahrten (wiederholte Zyklen). Sie laufen solange, bis Aufgabenstellung und Ergebnis zusammenpassen. Ohne validierten Nachweis kann ein Agent eine Aufgabe nicht abschließen.
Human in the Loop bleibt. Ist der Loop durch, braucht es die menschliche Freigabe. Agents können planen, implementieren, Tests vorschlagen, gegen Akzeptanzkriterien prüfen. Sie dürfen nicht mergen. Jedes agentisch erzeugte Artefakt bleibt Entwurf, bis ein Mensch es prüft, die Verantwortung übernimmt und freigibt.
Stefan Lieser, Mitbegründer der Clean Code Developer Initiative, zieht eine Analogie:
„Niemand schaut in den vom Compiler generierten Maschinencode. So wird es auch mit der KI passieren: niemand wird mehr in den Code schauen, wenn die KI aus Anforderungen lauffähige Software macht.“ (Stefan Lieser)
Würde das eintreten, wäre Clean Code überflüssig. Das ist aus drei Gründen (noch) nicht der Fall.
Clean Code war ein Werkzeugkasten. Heute dient Clean Code als Leitplanke für die Softwareentwicklung mit KI.
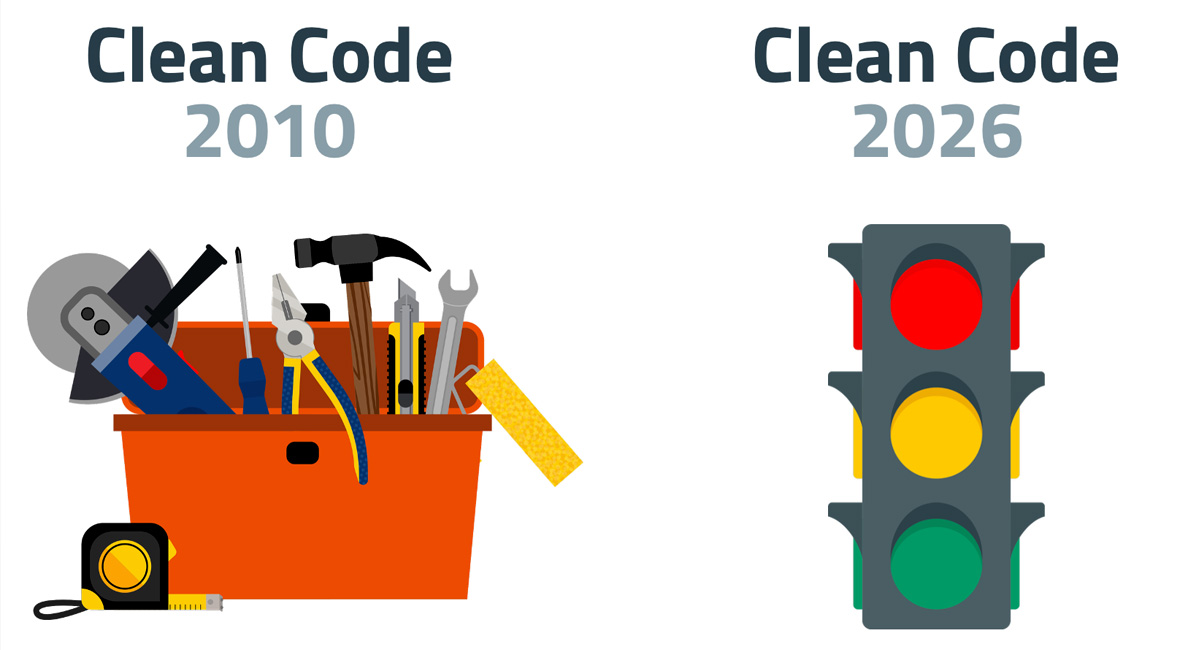
Unsere Verantwortung:
Als Dienstleister haben wir den Anspruch, Code so zu entwickeln, dass er verständlich ist und verantwortet werden kann. Verantworten muss ihn der Kunde, dem der Code gehört.
Sie müssen nicht jede Zeile selbst schreiben. Sie müssen jede Zeile verantworten können.
Die Vorteile mit KI in der Softwareentwicklung sind real, hängen allerdings stark davon ab, wie KI eingesetzt wird. Sie entstehen vor allem, wenn in der ersten Phase sauber gearbeitet wurde.
Früh greifbare Ergebnisse: KI liefert in kürzester Zeit einen Prototypen, der als Entscheidungsgrundlage dient. Der Fachbereich sieht, wie sich eine Lösung anfühlt, und kann gezielt nachschärfen. So sterben falsche Annahmen, bevor sie Budget bindet. Der Vorteil bleibt aus, wenn niemand den Vorschlag einordnen und bewerten kann, denn ein Prototyp ist kein fertiges Produkt, dass den Unternehmensanforderungen standhält.
Schnellere Time-to-Increment: Durch schnelleres Vertesten von Produktinkrementen kann Nutzerfeedback zeitnah eingeholt werden. Das senkt das Risiko, lange zu entwickeln und erst spät zu merken, dass es das Falsche war. Im Dual Track lassen sich Routine, Umsetzung und Tests so beschleunigen, dass Inkremente bis zu dreimal schneller bei echten Anwendern sind, wenn Kontext und Gates stehen.
Mehr Wert im selben Budget: Weniger Zeit in der Code-Entwicklung bedeutet nicht weniger Ingenieure. Allerdings kann Kapazität dorthin wandern, wo sich Enterprise-Software von Standardsoftware unterscheidet: in Requirements, Domänenmodell, Architektur und Review. Der Vorteil bleibt aus, wenn die Zeitersparnis beim Coden als Headcount-Reduktion verbucht wird statt als Investition in die Requirements- und Context Engineering und Quality Review.
Investitionsschutz: Software in der Industrie lebt länger als das Projekt, das sie hervorbringt. Oft sind das fünf bis fünfzehn Jahre. Was über diese Zeit veränderbar bleibt, hält den Kunden unabhängig und handlungsfähig. Der Quellcode bleibt prüfbarer Teil des Knowledge Graphen. Quality Gates gelten für Mensch und KI gleichermaßen. Das war schon vor KI der wirtschaftliche Kern. Mit KI wird es zur Funktionsvoraussetzung: Ohne diese Absicherung wächst aus jeder schnellen Iteration schneller Comprehension Debt, als ein Team ihn abbauen kann.
Kontrolle statt Blackbox: Nachvollziehbare Ergebnisse machen Qualität durchgehend im Loop sichtbar: Test, Evidence Gate, Review, menschliche Freigabe. Agents dürfen planen, entwickeln und prüfen. Die Ownership bleibt beim Menschen. Tempo entsteht damit nicht auf Kosten der Kontrolle, sondern zusammen mit ihr. Der Vorteil bleibt aus, wo Reviews zur Weiter-Klickerei werden: Dann ist die Blackbox nur schneller geworden.
Mitlaufende Dokumentation: Dokumentation war lange ein Engpass. Sie fiel nach der Entwicklung an und wurde selten vollständig nachgezogen. Mit Knowledge Graph und Agent Harness entsteht sie mit und teilweise automatisch: Anforderungen, Entscheidungen und Architekturbegründungen werden festgehalten, während entwickelt wird, nicht danach. Der Vorteil bleibt aus, wo Dokumentation weiter als Nacharbeit gilt.
Wachsender Wert über Projekte hinweg: Der Knowledge Graph ist kein Artefakt, das mit Projektabschluss veraltet. Jede Entscheidung, jede Anforderung, jede Architekturbegründung steht dem nächsten Feature und dem nächsten Vorhaben als Kontext zur Verfügung. Klassische Dokumentation verliert mit der Zeit an Wert, weil sie veraltet. Der Graph gewinnt, je länger und je konsequenter ein Unternehmen ihn pflegt. Wissen liegt dann nicht mehr nur in Köpfen, sondern steht der nächsten KI-Generation zur Verfügung. Der Vorteil bleibt aus, wenn der Graph nicht gepflegt wird.
Das A und O ist, ein gemeinsames Problemverständnis, maschinenlesbarer Kontext, Qualitätssicherung mit Nachweis, menschliche Freigabe und Kapazitäten und Ressourcen rund um die Codeentwicklung zu verlagern.
Gegenmittel sind unspektakulär und genau deshalb wirksam: kleinere Change-Sets · Explain before Accept · Test zuerst · Plan als Artefakt vorab, Plan explizit machen · nach Gegenargumenten fragen (das ist der Loop) · Kontexthygiene: neuer Task, neuer Kontext, gegebenenfalls neuen Agent öffnen.
Was ein Entwicklerteam den ganzen Tag tut, war nie hauptsächlich Code schreiben. Es klärt Anforderungen, entscheidet Architektur, plant, entwickelt, testet, reviewed und bringt Software in Betrieb. KI beschleunigt einen dieser Schritte. Der Wert wandert in die Phasen davor und danach: Requirements Engineering am Anfang, Prüfung und Freigabe am Ende.
Ein LLM füllt die Lücke, die Sie offen lassen, mit dem Wahrscheinlichsten, nicht mit dem für Sie Richtigen. Die Lücke wird nicht als Lücke sichtbar. Wer an diesen Phasen spart, zahlt meist dreifach: in Lösungen, die keiner braucht, in technischen Schulden und in Software, die niemand mehr versteht. Seit 2026 hat der letzte Punkt einen Namen: Comprehension Debt.
Ein Vibe-Coding-Prototyp ist nicht gleichzusetzen mit einem lauffähigen Produkt. Der Prototyp zeigt, dass etwas geht. Er zeigt nicht, dass es betrieben werden kann: nicht, ob es in Prozesse, Systeme und den Betrieb passt, und nicht, wer den Code in fünf Jahren noch verantwortet.
Das Richtige richtig entwickeln ist dann der Maßstab, der nach dieser Verschiebung übrig bleibt.
Das Richtige heißt: ein Problem lösen, das es wert ist, gelöst zu werden.
Richtig heißt: Software entwickeln, die wartbar, prüfbar und über Jahre weiterentwickelbar bleibt.
Dafür braucht es maschinenlesbaren Kontext, Quality Gates und Loops, und Clean Code. Clean Code war ein Werkzeugkasten. Heute dient Clean Code als Leitplanke für die Softwareentwicklung mit KI.
Sie müssen nicht jede Zeile selbst schreiben. Sie müssen jede Zeile verantworten können.
Zwei Minuten Ehrlichkeit reichen, um zu sehen, an welcher Phase bei Ihnen der Engpass sitzt.
Nehmen Sie sich die Punkte durch. Haken Sie an, was zutrifft:
0 bis 1 Häkchen: Sie sind früher als die meisten Teams. Genau dann lohnt sich eine Einordnung, bevor Tempo die Standards überholt.
2 bis 3 Häkchen: Das ist das typische Bild. Der Engpass sitzt nicht im Modell, sondern bei Kontext, Anforderungen und Review.
4 oder mehr: Sie beschleunigen das Coden und sparen an den Phasen, die KI erst treffsicher machen. Ein weiteres Sprachmodell löst das nicht.
Sparen Sie gerade am richtigen Ende? Sprechen Sie mit uns. Im Gespräch klären wir, wo Sie stehen und was als Nächstes sinnvoll ist. Wir sagen Ihnen auch, wenn Sie das intern lösen können und kein Projekt brauchen. Nicht jedes Gespräch führt zu einem Auftrag.
Schreiben Sie uns an team@generic.de oder rufen Sie an unter +49 721 6190960.
1. Ersetzt KI Softwareentwickler:innen?
Nein. Was ein Entwicklerteam den ganzen Tag tut, war nie hauptsächlich Code schreiben. KI beschleunigt diesen einen Schritt. Die Arbeit wandert zu Verstehen, Entscheiden, Prüfen und Verantworten. Der State of DevOps Report 2025 zeigt dasselbe Bild: mehr Tasks, mehr Pull Requests, und die gesparte Zeit landet in Prüfung und Freigabe.
2. Ist ein Vibe-Coding-Prototyp ein Produkt?
Nein. Er eignet sich als Entscheidungsgrundlage. Ein Produkt muss betrieben, angebunden und über Jahre verantwortet werden können. Das Modell liefert das nicht mit, wenn niemand es einfordert.
3. Was unterscheidet Copilot von agentischer Entwicklung?
Copilot beschleunigt das Coden in der IDE. Agentische Entwicklung arbeitet in einer KI-Entwicklungsumgebung: mit Agent Harness, Knowledge Graph, Guardrails, Quality Gates und menschlicher Freigabe. Das Modell ist der kleinere Teil. Die Umgebung entscheidet, ob das Ergebnis treffsicher und verantwortbar ist.
4. Ist Clean Code durch KI überflüssig?
Nein. Verantworten muss den Code der Kunde, dem er gehört. Dafür muss der Code verständlich bleiben. Clean Code ist der Maßstab dafür, für Mensch und Modell. Die Compiler-Analogie trägt hier nicht: Ein Compiler übersetzt deterministisch, ein Sprachmodell nicht.
5. Was ist ein Knowledge Graph?
Eine maschinenlesbare Wissensdatenbank: Anforderungen, Entscheidungen, Kundenaussagen, Architektur, Code und Tests, miteinander verknüpft. Mensch und KI arbeiten auf demselben Stand. Über Phasen und Projekte hinweg gewinnt der Graph an Wert, wenn er gepflegt wird.
6. Was ist Context Engineering?
Context Engineering legt für jede Aufgabe den relevanten Ausschnitt aus dem Knowledge Graph fest. Zu wenig Kontext erzeugt Annahmen. Zu viel Kontext senkt die Qualität. Es geht um Auswahl, nicht um Vollständigkeit.
7. Was ist ein Agent Harness?
Die KI-Entwicklungsumgebung (AI IDE) ist das Gesamtsystem. Darin liegt der Agent Harness: Modell, Rules, Skills und die Steuerung darum herum. Der Harness greift auf den Knowledge Graph als Langzeitspeicher zu und über Schnittstellen (etwa MCP) auf angebundene Systeme. Das Modell liefert nur einen kleinen Teil der Wertschöpfung. Der Harness macht den Einsatz steuerbar, wiederholbar und prüfbar.
8. Wie realistisch ist „bis zu dreimal schneller“?
Dann, wenn Problemverständnis, Kontext und Gates stehen. Als Versprechen ohne diese Voraussetzungen ist man dreimal schneller beim Falschen.
9. KI in der Softwareentwicklung oder KI im Produkt, was ist der Unterschied?
Das eine ist, wie ein Team entwickelt. Das andere ist, was das Produkt kann, etwa Prognose oder Assistenz. Beides kann zusammengehören. Die Entscheidung sollte man nicht vermischen.
10. Für welche Unternehmen lohnt sich dieser Weg?
Für Vorhaben, in denen Software im Kerngeschäft liegt: typisch Industrie, lange Lebensdauer, hohe Integrations- und Haftungsanforderungen. Kleine, klar abgegrenzte Tools setzen viele Teams bereits intern um. Sobald Prozesse, Systeme und Verantwortung zusammenkommen, reicht Vibe-Coding nicht.
11. Können wir das nicht selbst mit KI?
Ja. Kleine, klar abgegrenzte Tools setzen viele Teams bereits intern um. Der Maßstab bleibt derselbe: klares Problem, maschinenlesbarer Kontext, Quality Gates, menschliche Freigabe, Clean Code als Leitplanke. Wer das diszipliniert aufsetzt, braucht uns dafür nicht. Wo dieser Standard im Unternehmen noch nicht sitzt, helfen wir, ihn einzuführen, nicht weil Sie es nicht könnten, sondern damit Tempo die Kontrolle nicht überholt.
12. Wie hängt das mit Dual Track Agile zusammen?
Discovery klärt das Richtige, Delivery entwickelt richtig, der Knowledge Graph verbindet beides. So laufen Verstehen und Entwickeln parallel, ohne dass Agenten unklare Annahmen in Code gießen. Mehr dazu: Dual Track Agile.
Das Richtige richtig entwickeln
Zwei Rahmenbedingungen: ein Problem lösen, das es wert ist, und Software so entwickeln, dass sie wartbar, prüfbar und über Jahre weiterentwickelbar bleibt.
LLM (Large Language Model)
Wahrscheinlichkeitsmodell. Es versteht nicht, es sucht die nächste Fortsetzung. Offene Lücken füllt es mit dem Wahrscheinlichsten, nicht mit dem für Sie Richtigen.
Vibe Coding
Software per natürlicher Sprache entwickeln, ohne den generierten Code wirklich zu lesen oder zu verstehen. Ein Vibe-Coding-Prototyp zeigt, dass etwas geht. Er ist nicht gleichzusetzen mit einem lauffähigen Produkt.
Comprehension Debt
Die Lücke zwischen erzeugtem und verstandenem Code. Der Code kann sauber aussehen und trotzdem niemand mehr erklären, warum er so ist. Ein Risiko für Wartung und Haftung.
Knowledge Graph
Maschinenlesbare, verknüpfte Wissensdatenbank von der Vision bis zum Test. Single Source of Truth für Mensch und Agent. Wird über Phasen und Projekte hinweg erweitert. In manchen Unterlagen steht „Kontext Graph“, gemeint ist dasselbe, nicht ein zweites System.
Context Engineering
Den für die Aufgabe relevanten Ausschnitt aus dem Graph bereitstellen. Auswahl statt Vollständigkeit.
Kontextfenster
Die Menge an Kontext, die ein Modell in einem Durchgang verarbeiten kann. Ab einem gewissen Volumen sinkt die Qualität, mehr reinkippen hilft dann nicht.
KI-Entwicklungsumgebung (AI IDE)
Das Gesamtsystem, in dem agentisch entwickelt wird. Enthält den Agent Harness, den Zugriff auf den Knowledge Graph und die Anbindung weiterer Systeme.
Agent Harness
Der Teil der KI-Entwicklungsumgebung um das Modell: Rules, Skills, Guardrails, Tests, Observability, Freigaben. Greift auf den Knowledge Graph als Langzeitspeicher zu. Das Modell ist der Motor. Der Harness entscheidet, ob der Motor steuerbar bleibt.
Guardrails
Die Verkehrsregeln für das Modell. Sie begrenzen, was die KI tun darf, bevor ein Ergebnis weitergeht.
Quality Gate
Der Grenzposten. Ein Prüfpunkt mit Nachweis. Ohne Nachweis kein Weitergehen.
Loop
Wiederholte Zyklen, bis Aufgabenstellung und Ergebnis zusammenpassen. Ohne validierten Nachweis kann ein Agent eine Aufgabe nicht abschließen.
Human in the Loop
Nach dem Loop die menschliche Freigabe. Agents dürfen planen, entwickeln und prüfen. Sie dürfen nicht mergen. Jedes agentische Artefakt bleibt Entwurf, bis ein Mensch die Verantwortung übernimmt.
Dual Track Agile
Discovery und Delivery parallel. Ein Arbeitspaket geht erst in die Umsetzung, wenn es klar genug erforscht ist.
Clean Code
War ein Werkzeugkasten. Heute die Leitplanke für die Softwareentwicklung mit KI: derselbe Maßstab für Mensch und Modell. Bestehender Code ist Kontext für das nächste Feature. Verständlicher Code beugt Comprehension Debt vor. Nicht jede Zeile selbst schreiben, jede Zeile verantworten können.
Dev-ready
Der Punkt, an dem Vision, Lösungskonzept, Graph und Entwicklungsumgebung stehen. Erst dann schreiben Mensch oder Agent Code.
Review-Fatigue
Die prüfende Person ermüdet, weil mehr Code in kürzerer Zeit geprüft werden muss. Dann entstehen Fehler, oder Inkremente gehen ungeprüft durch.
Hier erfährst Du, was Dual-Track Agile ist und wie es bei der der Software- und Produktentwicklung helfen kann!
Auf welche Softwarequalitätsmerkmale es aus technischer & wirtschaftlicher Sicht ankommt und wie Clean Code Development dabei helfen kann, diese zu erreichen